Estatística descritiva para product managers - Parte 3
Se você acompanhou a Parte 1 e a Parte 2, já entendeu que a média é "traiçoeira" e que o desvio padrão é quem nos conta a verdade sobre a consistência do nosso produto.
No texto anterior, usamos o exemplo do tempo de checkout do nosso app de delivery: [5, 7, 6, 8, 10, 5, 9, 8, 7, 12 minutos]. Vimos que a média era 7,7 minutos, mas com uma variação importante.
Agora, vamos elevar o nível. Para descrever dados com precisão, precisamos parar de olhar para o todo como uma massa única e começar a "fatiar" esses dados.
Nessa parte 3, falaremos então de posições: percentis, quartis e o boxplot — conceitos que vão refinar a sua capacidade de leitura de dados e te ajudar a enxergar padrões que a média esconde.
Percentis: onde a "mágica" (e o problema) se esconde
A média tenta resumir tudo em um número. O percentil te diz exatamente onde cada usuário está na fila.
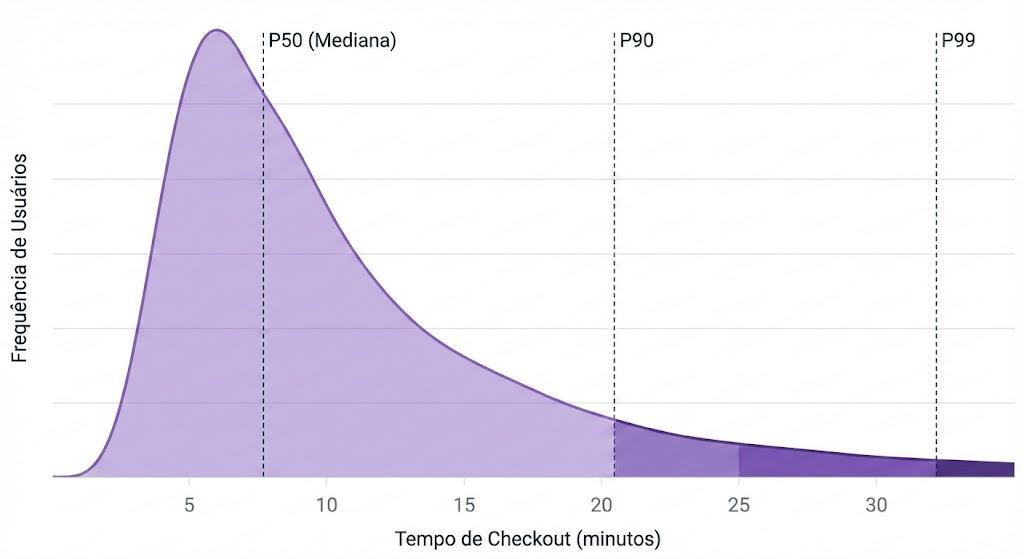
O percentil é uma medida que divide a sua amostra ordenada (do menor para o maior) em 100 partes. Se dizemos que o P90 (percentil 90) do nosso checkout é 10 minutos, significa que 90% dos usuários terminam a compra em 10 minutos ou menos. Consequentemente, os outros 10% levam mais que isso.
Visualmente, é assim que isso se parece em uma distribuição de dados real (note como os dados se esticam para a direita, criando uma "cauda"):
Por que o mercado fala tanto de P95 e P99?
Olhando para o gráfico acima, você pode pensar: "Se a grande montanha de usuários está segura à esquerda, por que me preocupar com o final da cauda (P99)?".
A resposta é dinheiro e retenção. Em produtos digitais, o P99 (o 1% com pior experiência) raramente é um usuário aleatório. Muitas vezes, esse 1% representa seus usuários muito engajados — clientes que têm carrinhos de compra gigantes, históricos de dados longos ou configurações complexas.
Existem dados de mercado clássicos sobre isso:
- Amazon: Greg Linden divulgou que cada 100ms de latência extra custava 1% em vendas.
- Google: Marissa Mayer apresentou dados mostrando que 0,5 segundo a mais no tempo de busca derrubava o tráfego em 20%.
Otimizar para a média mantém o produto "ok". Otimizar para os percentis extremos (reduzindo essa "cauda longa" que vimos no gráfico) garante que seus clientes mais valiosos não fiquem frustrados.
Claro, quando você está começando uma empresa, é provável que não focará nesse cenário que acabei de mencionar, a não ser que seja uma empresa B2B de grandes tickets e poucos clientes, o que torna mais crítico ainda diminuir a cauda do gráfico do percentil.
Quartis e a Amplitude Interquartil (IQR): o seu filtro de ruído
Se dividirmos os dados não em 100, mas em 4 partes iguais, temos os Quartis. Pense neles como marcos quilométricos da sua operação:
- Q1 (1º Quartil / P25): 25% dos dados estão abaixo deste valor. É o limite dos seus usuários "mais rápidos".
- Q2 (2º Quartil / P50): É a famosa Mediana. O centro exato da fila.
- Q3 (3º Quartil / P75): 75% dos dados estão abaixo. Aqui começam os seus usuários mais lentos.
A mágica acontece quando calculamos a distância entre o Q1 e o Q3. Isso se chama Amplitude Interquartil (IQR - Interquartile Range).
A conta é simples: IQR = Q3 - Q1.
Mas por que um PM deveria se importar com isso? Porque o IQR define a Zona de Normalidade do seu produto. Ele ignora os 25% mais rápidos (que não são problema) e os 25% mais lentos (que podem ser caos ou outliers), focando exclusivamente nos 50% centrais da sua base.
Exemplo prático: O falso positivo no Delivery
Imagine que você gerencia a logística do app. Em um dia normal, seus tempos de entrega (em minutos) para 10 pedidos são: [20, 22, 24, 25, 26, 28, 30, 32, 35, 40]
- Média: 28,2 min.
- IQR: 7,25 min (Variando de ~24 a ~31,5).
Agora, imagine um dia de chuva onde um único entregador teve a moto quebrada e demorou 180 minutos (3 horas) para entregar. Seus dados ficam assim: [20, 22, 24, 25, 26, 28, 30, 32, 35, 180]
Olhe o que acontece com as métricas:
- Média: Salta para 42,2 min (Aumento de 50%).
- IQR: Continua sendo ~7-8 min.
Se você olhar apenas para a média, o sinal é de que a performance degradou drasticamente. Isso pode levar a decisões precipitadas: você pode acabar mobilizando o time para rever processos inteiros ou corrigir uma falha sistêmica que, na verdade, não existe.
Ao olhar para o IQR, o diagnóstico é claro: "A operação central continua estável (o miolo de 50% dos pedidos não mudou). Tivemos apenas casos extremos pontuais". O IQR é o filtro que impede o PM de agir sobre ruídos.
Boxplot: o gráfico que te dá um voo panorâmico dos seus dados
Você já deve ter visto no Jira, no Metabase ou em ferramentas de performance um gráfico que parece uma caixa com dois "bigodes" (linhas) saindo das pontas. Esse é o Boxplot (ou Diagrama de Caixa).
Mas antes de aprendermos a ler, precisamos entender por que ele existe.
O Boxplot não nasceu em um software moderno de BI. Ele foi criado na década de 1970 pelo matemático John Tukey, uma lenda da estatística que cunhou o termo "bit" e foi pioneiro na Análise Exploratória de Dados (EDA).
Tukey percebeu um problema grave: a maioria dos estatísticos da época era obcecada pela "Curva Normal" (aquela em forma de sino). Eles tentavam encaixar todos os dados do mundo nessa curva perfeita. O problema é que a vida real — e os dados de produtos digitais — raramente é normal. Nossos dados são caóticos, assimétricos e cheios de outliers.
Tukey queria uma forma de resumir a "personalidade" de um conjunto de dados em um único desenho, sem precisar fazer suposições complexas. Ele criou então o conceito do Resumo de 5 Números:
- O Mínimo
- O 1º Quartil (Q1)
- A Mediana
- O 3º Quartil (Q3)
- O Máximo
O Boxplot é simplesmente a representação visual desses cinco números.
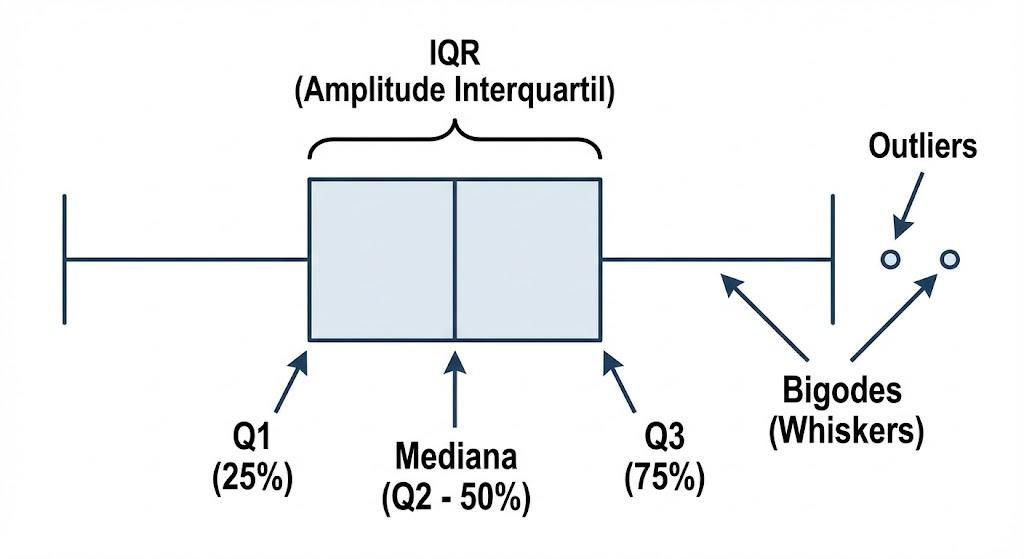
Ele é a ferramenta definitiva para responder em um segundo: "Meus dados são normais ou estão caóticos?".
Lendo o Boxplot na prática (com nossos dados de delivery)
Vamos aplicar o conceito de Tukey aos nossos dados do "Dia Normal" ([20, 22, 24, 25, 26, 28, 30, 32, 35, 40]):
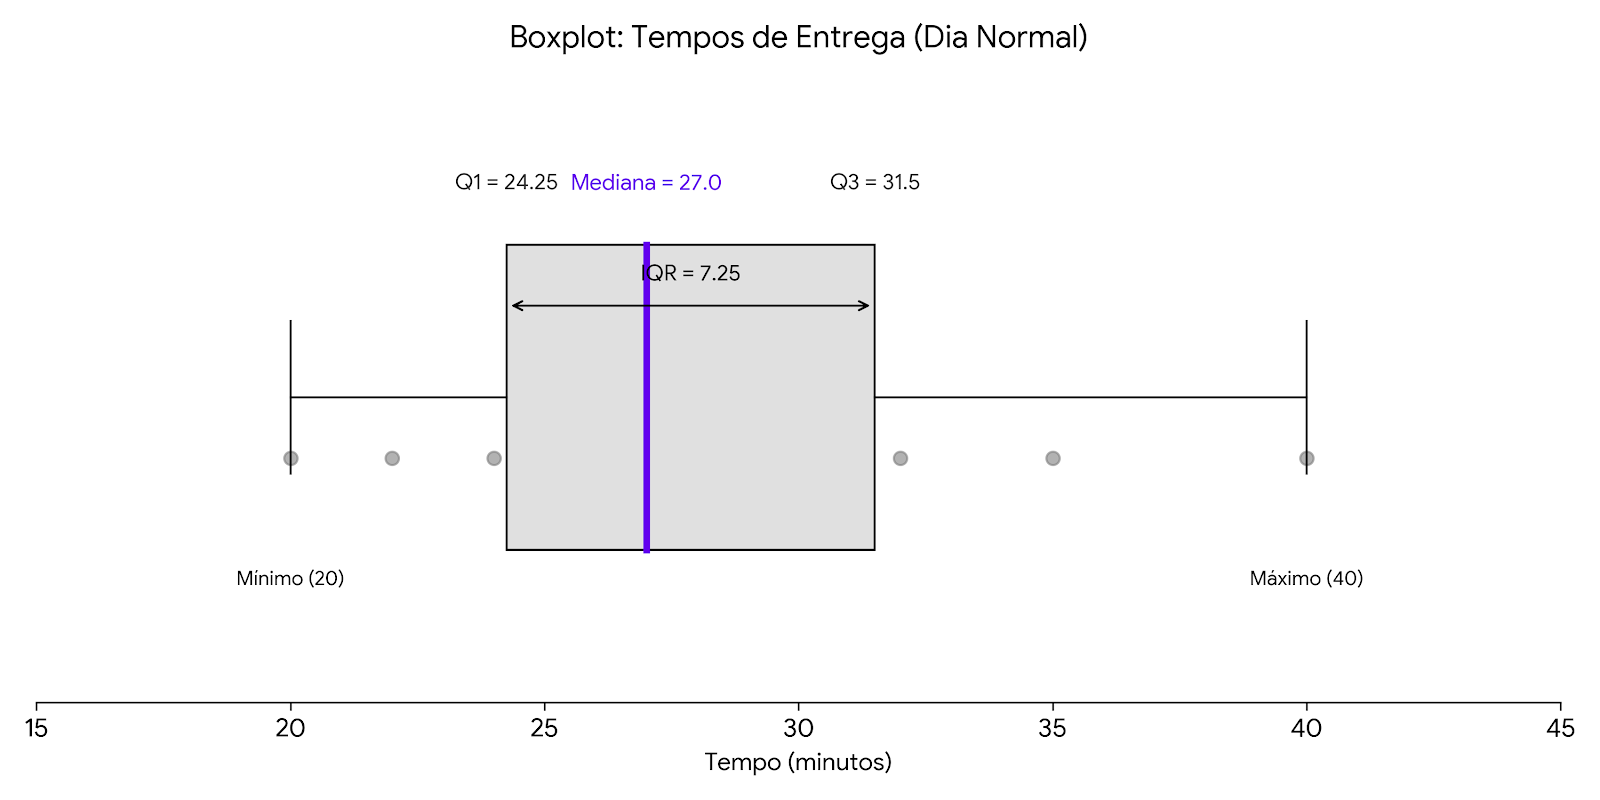
Conectando os pontos:
- A "caixa" laranja (IQR): é o coração do gráfico. Ela vai do Q1 (24,25) ao Q3 (31,5).
- O que isso significa pro PM? Metade de todas as suas entregas aconteceram ali dentro. Essa é a sua "zona de conforto" operacional. Se essa caixa for estreita, seu processo é padronizado. Se for larga, cada cliente tem uma sorte diferente.
- A linha Roxa (mediana): ela está no 27.
- A mediana corta a caixa. Se ela estiver bem no meio, seus dados são simétricos. Se ela estiver "colada" em uma das pontas da caixa, seus dados estão distorcidos (assimétricos).
- Os bigodes (whiskers): as linhas pretas que se estendem para fora.
- Elas mostram até onde os dados vão dentro do que é considerado "estatisticamente razoável". Geralmente, eles vão até 1,5x o tamanho da caixa (IQR). Tudo o que cai fora do bigode é considerado uma anomalia.
- Os outliers (pontos fora):
- Se tivéssemos aquele entregador de 180 minutos, ele apareceria como um ponto solitário lá na direita, bem longe do bigode máximo. O Boxplot deixa claro para você: "Isso aqui não é normal, investigue!".
Não perca tempo olhando planilha linha a linha na segunda-feira de manhã. Plote um boxplot semanal. Se a caixa estiver pequena, seu processo é maduro. Se estiver grande, seu produto é instável. E se houver muitas bolinhas fora dos bigodes, você tem bugs ou falhas graves para investigar.
Agora você sabe descrever com exatidão onde os dados estão e como filtrar o ruído do dia a dia. Mas fica a pergunta: será que essa amostra de dados que analisamos no app de delivery representa a realidade de todos os usuários do Brasil? Podemos confiar nesses números para prever o mês que vem?
É aqui então que chegamos ao fim desta série sobre estatística descritiva e entraremos no campo da estatística inferencial para responder a essa pergunta.
Na próxima parte, falaremos sobre Teorema do Limite Central, Intervalos de Confiança e entender, matematicamente, por que Testes A/B funcionam.
Até lá.
Referências
- Greg Linden (Amazon): Make Data Useful (Stanford Presentation).
- Google Research: Speed Matters.
- Google SRE Book: Capítulo sobre "The Tail at Scale".
- Charles Wheelan: Naked Statistics.