Estatística descritiva para PMs - Parte 2
Para ver a parte 1 dessa série de textos, clique aqui.
Na primeira parte desta série, trouxe os conceitos mais básicos da estatística descritiva, mas que são conceitos fundamentais para entender as distribuições de dados e identificar tendências centrais.
Como vocês viram, quando a gente olha para média e para mediana, por vezes, temos uma dispersão que não conseguimos enxergar tão facilmente, exceto se analisemos extremos dos conjuntos.
E melhor do que olhar um conjunto número a número, é utilizar as técnicas da estatística que abordaremos aqui nesse texto e que vão nos ajudar a entender melhor a variabilidade e a dispersão dos nossos dados.
Entender esses elementos é fundamental para que a gente não tome decisões erradas ou deixe de fora casos de uso importantes para o nosso produto. Vamos então a nossa primeira medida: a variância.
Variância: a quantificação da dispersão
Variância é uma medida estatística que quantifica o grau de dispersão dos valores de um conjunto de dados em relação à média.
É dada pela fórmula:
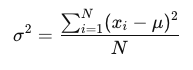
Onde:
- N é o número de dados.
- xi são os valores individuais no conjunto de dados.
- é a média dos dados.
- ∑ representa um somatório.
Ela calcula a média das diferenças ao quadrado entre cada valor e a média, fornecendo uma visão sobre o quanto os dados estão espalhados ou concentrados. Quanto maior a variância, mais os dados variam em relação à média, o que para o nosso dia a dia de produto, pode indicar problemas em nossos produtos.
Sim, eu sei que você pode estar meio perdido agora. Que raios significa "a média das diferenças ao quadrado dos dados em relação à média do conjunto"?
Pois bem, vamos por partes.
A diferença de um elemento do conjunto em relação à média nos mostra a distância que aquele elemento está da média. Por exemplo, se a média de um conjunto de dados é 7 e um dos valores é 5, a distância desse valor à média é 5 - 7 = -2. Simples.
A diferença ao quadrado é então (-2)2= 4.
Mas por que elevar ao quadrado?
Como você pode ver, ao elevar a diferença ao quadrado você está tirando os valores negativos da conta. Se somássemos as diferenças simples (distâncias) dos valores à média, os valores negativos e positivos poderiam se cancelar, resultando em uma soma próxima de zero mesmo que os dados estivessem espalhados. Ao elevar ao quadrado, evitamos isso porque todas as diferenças se tornam positivas.
Elevar ao quadrado também torna o cálculo mais sensível a valores que estão muito longe da média (outliers). Valores que estão muito distantes da média terão um impacto muito maior na variância, destacando a presença de outliers na análise.
A variância então é a somatória das diferenças ao quadrado.
É por isso, que, matematicamente, a unidade da variância é ao quadrado da unidade original dos dados. Ou seja, se o nosso conjunto é de medidas em minutos, a variância será medida em minutos ao quadrado (minutos²).
A maioria de nós simplifica esse fato, e olha para o que a variância indica, que é a dispersão do nosso conjunto de dados.
Interpretar o valor da variância dependerá da escala do nosso conjunto de dados. Não existe um valor fixo que diz que a variância é alta ou baixa.
Por exemplo, se você está analisando o tempo que uma ação demora para ser realizada no seu produto e calculou a variância de um conjunto de usuários com o resultado sendo 5 minutos², isso quer dizer que existem usuários demorando 5 minutos a mais terminar uma ação do que a média dos usuários.
Interpretar se essa variância é ruim ou não, depende então do contexto.
Para ficar mais claro, voltemos ao nosso exemplo em que você é o Product Manager de uma empresa de delivery e está analisando o tempo que os usuários levam para completar uma compra.
Você tem os dados de tempo de conclusão de compra para 10 usuários: [5, 7, 6, 8, 10, 5, 9, 8, 7, 12 minutos].
Primeiro, você calcula a média, sendo 7,7 minutos:
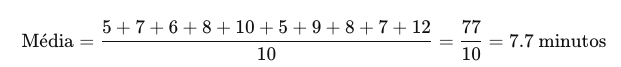
Agora, você subtrai a média de cada valor do seu conjunto e eleva essa diferença ao quadrado:
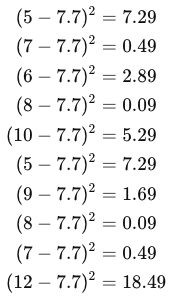
E por último, calcula a média do conjunto formado pelos valores das diferenças ao quadrado [7.29, 0.49, 2.89, 0.09, 5.29, 7.29, 1.69, 0.09, 0.49, 18.49]:
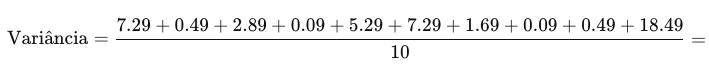
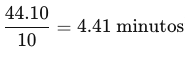
Temos aqui então que a variância do seu conjunto é de 4,41 minutos².
Isso significa que existem usuários que, significantemente, estão demorando mais que a média e outros terminando mais rapidamente. Isso é ruim? Sabemos que o fechamento de uma compra é algo muito sensível e que existindo essa variância de tempo em nossos usuários, certamente muitos estão desistindo de comprar.
Nesse caso, entendendo que há uma dispersão no conjunto, é interessante buscar os extremos para menos e para mais e entender o que está acontecendo na jornada.
Eu sei que você deve estar se perguntando, mas esses 4.41 minutos não significam que perante a média, tem usuários fechando a compra em 7.7 - 4.41 = 3.29 minutos ou em 7.7 + 4.41 = 12.11 minutos?
Pois é, eu também pensava dessa forma, mas se você se lembrar bem, a variância é medida em quadrados, então, não conseguimos afirmar o que dissemos, visto que as unidades estão em medidas diferentes.
É por isso que a maioria das pessoas acaba usando o desvio padrão.
Desvio padrão: simplificando a variância
Enquanto a variância nos dá uma ideia da dispersão dos dados, o desvio padrão torna essa informação mais prática e compreensível, pois é expresso na mesma unidade dos dados originais. O desvio padrão é simplesmente a raiz quadrada da variância:
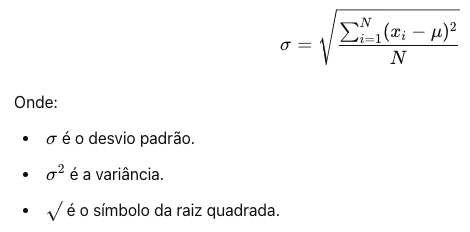
O desvio padrão é importante porque, ao contrário da variância (que é expressa em unidades ao quadrado), ele nos dá uma medida direta da dispersão dos dados em relação à média, na mesma escala dos dados originais. Isso facilita a interpretação dos resultados e permite uma análise mais intuitiva.
Continuando com o exemplo anterior, o desvio padrão será:
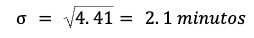
Esse valor de desvio padrão é uma medida mais direta que nos ajuda a entender rapidamente quão variável é o tempo que os usuários levam para completar uma compra.
Para a maioria dos usuários, então, o tempo de conclusão está entre 5,6 e 9,8 minutos. A interpretação desse valor depende do contexto do produto: se a consistência é importante, esse desvio padrão pode indicar uma necessidade de otimização; se alguma variabilidade é aceitável, esse valor pode ser considerado normal.
Aqui é muito importante dizer que o desvio padrão não nos diz muito sobre os extremos do nosso conjunto, uma vez que como vimos, tem usuário levando 12 minutos para fechar a compra. Mas ele nos ajuda a entender se existe uma grande dispersão em relação à média.
Ou seja, se ele fosse muito alto, isso poderia ser um sinal de que o processo de checkout precisa ser otimizado, talvez simplificando as etapas para reduzir a variabilidade e melhorar a experiência do usuário, porque certamente teria uma dispersão grande em nosso conjunto.
A regra empírica: entendendo a distribuição dos dados
A regra empírica é um princípio estatístico que se aplica principalmente a distribuições de dados que são aproximadamente normais. Ela nos permite entender a dispersão dos dados em torno da média de uma maneira mais detalhada, ao considerar múltiplos desvios padrões, inclusive para entender melhor perto dos extremos do nosso conjunto.
A Regra Empírica estabelece que, em uma distribuição normal:
- 68% dos dados estão dentro de 1 desvio padrão da média.
- 95% dos dados estão dentro de 2 desvios padrões da média.
- 99,7% dos dados estão dentro de 3 desvios padrões da média.
Essas porcentagens fornecem uma visão clara de como os dados se espalham e nos ajudam a fazer previsões sobre a distribuição, mesmo sem conhecer todos os detalhes do conjunto de dados.
Usado o nosso exemplo, aplicando a regra empírica nos tempos de conclusão do fechamento de pedido por nossos usuários, teremos:
- 1 Desvio Padrão (68% dos dados): aproximadamente 68% dos usuários completam o fechamento do pedido em um tempo que varia entre 7.7−2.1=5.6 minutos e 7.7 + 2.1 = 9.8 minutos.
- 2 Desvios Padrões (95% dos dados): aproximadamente 95% dos usuários levarão entre 7.7 - 4.2 = 3.5 minutos e 7.7 + 4.2 = 11.9 minutos para fechar o pedido.
- 3 Desvios Padrões (99,7% dos dados): quase todos os usuários (99,7%) completam o fechamento do pedido em um tempo que varia de 7.7 - 6.3 = 1.4 minutos e 7.7 + 6.3 = 14 minutos.
Você deve estar se perguntando, mas eu não tenho esses valores no meu conjunto. Sim, com bem disse no começo dessa sessão, para a regra empírica funcionar, o conjunto tem que estar em uma distribuição normal ou bem próximo disso.
O importante aqui é utilizar a regra empírica para entender como o seu conjunto funciona e acredite, na grande maioria das vezes, nossas distribuições serão normais, pois a natureza funciona assim.
Claro, papo para um outro texto. Na próxima edição, chegaremos a percentis e entenderemos como usá-los no nosso dia a dia de produto.
Até breve.